要点
- 監視対象と調査に必要な深さを決め、異常を受け取る担当者まで用意する。
- ホスト、メトリクス、ログ、APMの課金単位と保持期間を分けて見積もる。
- 同じ基盤への依存と通知の欠損を試し、AIの原因候補は記録と照合する。
システム監視ツールは、監視したい対象と、異常を受け取って動ける人から選ぶ。サーバーの停止を知りたいだけなのか、アプリの遅延を追いたいのか、複数環境のログを横断したいのかで、必要な機能も費用も変わる。
AWSやAzureが中心なら、それぞれの監視サービスを起点にできる。複数環境の基盤からアプリまで見たい場合はDatadog、New Relic、Dynatrace、Grafana Cloudなどが候補になる。自社で監視基盤を持つならZabbix、ホストの状態を中心に見たいならMackerelも候補だ。これは対象と体制を前提にした編集上の選定例であり、製品の順位ではない。
比較するときは月額の入口だけで決めず、ホスト数、ログやトレースの量、保存期間、利用者、通知とサポートを同じ条件にそろえたい。以下の製品・料金情報は2026年11月13日に各公式ページで確認した。条件は変わるため契約前に再確認する。
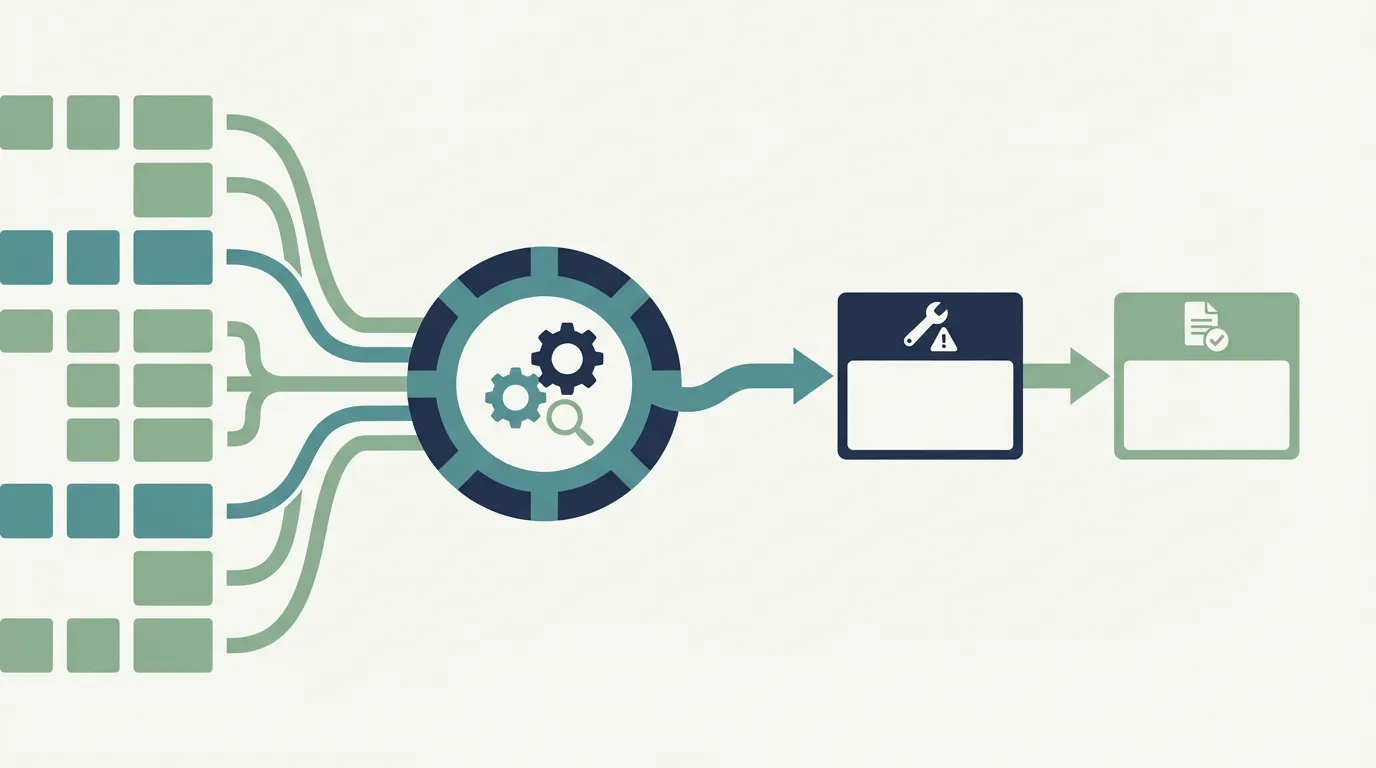
監視は、稼働状況や応答、ログなどを継続して観測し、異常を見つける仕組みである。CPU使用率やエラー率のような数値をメトリクス、個々の出来事の記録をログ、複数の処理をまたぐリクエストの流れをトレースと呼ぶ。数字に異常が出た時刻を手掛かりに、ログやトレースで何が起きたかを調べる。
通知は、監視で見つかった異常を担当者に知らせる段階だ。誰にも届かなければ、画面上に異常が表示されても対応は始まらない。夜間や休日も含め、担当者、代理、連絡先、対応する時間を決める必要がある。
バックアップはデータを復元するための備えであり、障害の検知とは別の役割を持つ。監視でストレージの異常を見つけても、失われたデータが自動で戻るわけではない。保存しただけでなく、復元できることの確認も必要だ。バックアップの復元試験も合わせて確認したい。
保存期間は事故の調査期間から逆算する。たとえば、月次処理で見つかる不具合を調べるなら、その処理が走った時点の記録が必要だ。ただし、すべてを同じ期間保存すると費用が増える。重要なログと細かなデバッグ情報を分け、必要な保持期間と検索方法を決める。個人情報や認証情報がログに含まれないかも点検したい。
各社の価格表を比較する前に、監視対象の一覧を作る。常時動くホストと一時的に増えるホスト、アプリの数、通常時と繁忙時のログ量、画面を操作する人数を分けて書く。メトリクスは項目数だけでなく、ラベルの組み合わせや取得間隔によって系列数やデータ量が増える場合がある。ログは平均だけでなく、障害時にエラーが急増した場合も見積もる。
たとえば月間ログ量が想定より増えると、取り込み費だけでなく、製品や設定によって保存・検索費も変わる。全部を長期間検索できる状態にする必要があるのか、重要なものだけを検索しやすい場所に残し、残りを別の保存先へ移せるのかを確認する。ただし移したデータを調査時に戻す手間や費用も比較に含める。
APMは対象とするアプリやホストの数だけで決まるとは限らず、トレースの取得量や保存条件が関わる製品もある。試用時の利用量をそのまま本番の請求額とみなさず、本番で増える対象、データ、閲覧者、保持期間を見積もりに反映する。契約更新時の条件や最低利用額、為替、サポート費も購入先に確かめる。
監視データには、取引先の識別子やアクセス元、エラーに含まれる入力値などが入ることがある。どのリージョンで保存・処理されるか、必要な部署だけが閲覧できるか、保存期間が過ぎた後にどう扱われるかを確認する。リージョンの選択肢は製品や機能、契約によって異なるため、対象の環境について個別に確かめたい。
保管場所を決めるだけでは足りない。障害時に担当者が必要なログへアクセスできる一方、不要な人が機密情報を見られない権限になっているかを試す。データの削除や設定変更を誰が行えるか、作業の記録をどこで確認するかも、導入時に決めておくと引き継ぎやすい。
表の料金単位は代表例であり、全機能が一つの単位に含まれるという意味ではない。金額は契約、対象、使用量、リージョンなどで変わる。公式情報で最新条件を確認する。
| 製品 | 主な用途・強み | 主な料金単位 | 条件・気をつけたい点 | 公式 |
|---|---|---|---|---|
| Datadog | 複数環境の基盤・アプリ・ログ | ホスト、APM、ログの取り込み量・索引など | 機能ごとに費用を確認。単純な死活監視だけなら対象を絞る | 公式情報 |
| New Relic | アプリと基盤の横断調査 | 取り込み量とユーザー、またはCompute利用量 | 契約モデルと利用者区分を確認 | 公式情報 |
| Dynatrace | 基盤からアプリまでの調査 | ホスト時間、メモリGiB時間、ログ量など | DPSの年間最低コミットを確認 | 公式情報 |
| Mackerel | ホストの状態と通知 | ホスト、メトリック、トレーススパン、ログ取り込み量 | ログは2026年11月利用分から課金。含有枠と超過を確認。ログ分析要件は別途確認 | 公式情報 |
| Zabbix | 自社管理のサーバー・ネットワーク | OSS本体はライセンス料不要。サポートは別 | 監視基盤の構築・更新を担う人が必要 | 公式情報 |
| Amazon CloudWatch | AWS中心のリソースとアプリ | メトリクス、ログ量、アラームなど | 対象とリージョン別に課金条件を確認 | 公式情報 |
| Azure Monitor | Azure中心のリソースとアプリ | ログ量、メトリクス、アラートなど | データ種別・保持・検索条件を確認 | 公式情報 |
| Grafana Cloud | メトリクス・ログ・トレースの可視化 | 系列、GB、ホスト時間など | 取得頻度と機能別の追加費用を確認 | 公式情報 |
インフラ、APM、ログを組み合わせ、障害時に関連する情報をたどりたい場合に候補となる。クラウドやアプリの担当者が同じ事象を見る場面で、必要な機能を試したい。
一方、インフラ監視のホスト料金だけで全体を見積もると不足する。APMの対象ホスト、ログの取り込み量、索引に残すイベントと保持期間、追加機能を分けて計算する。契約期間やオンデマンドの条件も確認する。
アプリと基盤の情報をまとめて調べたいチームで検討できる。アプリの遅延から関連するログや基盤の状態へ移り、調査に必要な情報を取得できるかを試す。
料金は契約形態の確認が先だ。公式にはデータ取り込みとユーザーを軸とする料金に加え、データとComputeの利用量を軸にするモデルも示されている。適用されるモデル、利用者区分、保持、追加機能を見積もりで確かめる。
インフラからアプリケーションまでの状態をまとめて把握し、処理の関連を調べたい環境で候補となる。Full-Stack MonitoringにはAPMが含まれ、インフラだけを対象とする選択肢もある。
DPSには年間最低利用額のコミットがある。Full-StackのメモリGiB時間、インフラのホスト時間、ログの取り込み・保持・検索などは同じ単位ではない。必要な対象と期間を明示して見積もる。
ホストのメトリックを見て異常を知らせたい場合に検討しやすい。まず監視するホストと、通常時の値を確認し、障害につながる変化に通知を設定する。
公式の料金計算ではホスト、メトリック、トレーススパン、ログ取り込み量が課金の基礎となる。ログ取り込み量は2026年11月利用分から課金される。ホストには一定のメトリック枠があるが、超過分は別に計算される。詳細なログ分析が必要な場合は、その要件を満たす方法と追加費用を個別に確認する。
自社で監視基盤を管理し、サーバーやネットワークなどを観測したい場合の候補である。ソフトウェアはライセンス料なしで使え、商用サポートは別に選べる。
無料であるのはソフトウェアのライセンスだ。稼働させるサーバー、データ保存、バックアップ、更新、設定変更、障害時の復旧には人手と費用がかかる。監視基盤自体を誰が維持するか決められない場合は、その負担を含めてクラウド型と比較したい。
AWSのリソースを中心に、メトリクスやログ、アラームを扱う場合の出発点となる。Application Signalsなど、アプリケーションを観測する選択肢もある。
標準で送られるメトリクスと、追加のメトリクスやログ、アラーム、アプリ観測の費用を分ける。無料枠があっても、ログの取り込み・保存・検索などはそれぞれ条件がある。利用リージョンを選び、実際の構成で試算する。
Azureリソースのメトリクスやログを見ながら、Application Insightsでアプリケーションの状態も調べたい場合に候補となる。Azure以外を含む構成では、必要なデータの収集方法を試用で確かめる。
ログ取り込みや保持、検索、アラートは種類や設定によって費用が異なる。標準の機能が使えることと、必要な全データが無料で保存・検索できることは別だ。テーブル種別や保持、通知条件を含めて確認する。
メトリクス、ログ、トレースを使い、ダッシュボードから状況を調べたいチームで候補になる。既存のデータ収集方法との接続や、担当者が必要な画面を作れるかを確認したい。
メトリクスはアクティブ系列と取得頻度など、ログはGBなど、Application Observabilityはホスト時間などで計算される。アプリ観測ではテレメトリーの料金も別に生じる条件がある。取得間隔を短くする前に、費用と調査上の必要性を比べる。
ここからは規模そのものではなく、同じ規模で起こりやすい条件を置いた編集上の例である。実際にはサービスの重要度や当番体制によって、必要な範囲は変わる。
まずは重要なサービスの外からの応答、ホストの稼働、容量不足を監視し、担当者に通知が届くことを確かめる。Mackerelや利用中のクラウド標準サービスを候補に、既存の契約と管理負担を比較する。自社で基盤を維持できるならZabbixも候補だ。無料枠に収まるかだけでなく、担当者が不在のとき誰が通知を見るかを決める。
サーバーが動いていても、特定のAPIだけ遅くなることがある。応答時間やエラー率に加え、ログとトレースで処理を追える構成を試す。Datadog、New Relic、Grafana Cloudなどを、実際のアプリ言語、収集量、チームの操作方法で比較する。全トレースを無条件に残す前に、調査に必要な粒度と保持期間を決める。
共通の画面だけでなく、チームごとの権限、費用の配賦、監視対象の追加手順、夜間の引き継ぎも必要になる。Dynatraceを含め各候補の契約条件と、既存の監視資産を移せる範囲を確認する。移行中は旧環境をすぐに止めず、同じ障害を検知できることと通知先を照合する。
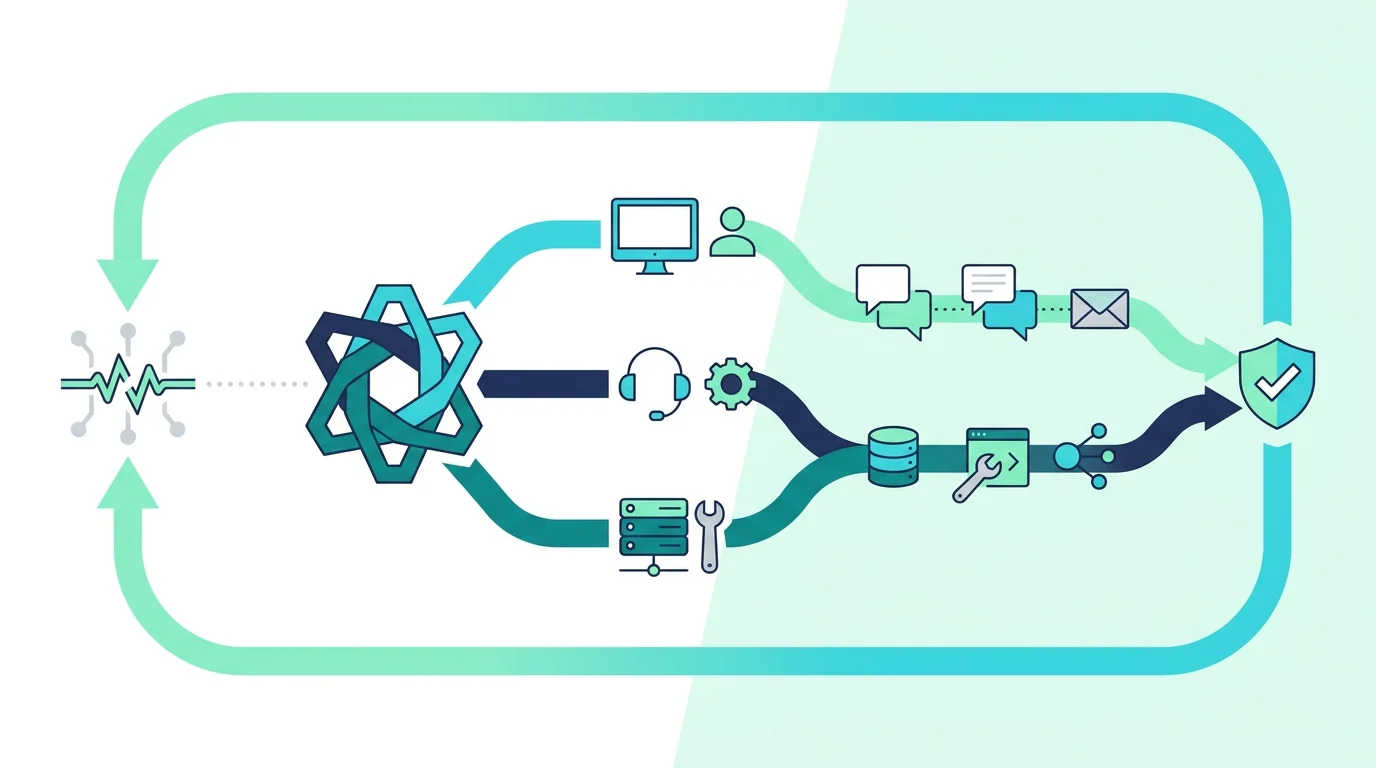
通知が多いほど安全とは限らない。短い変動をすべて夜間に通知すると、重要な障害が埋もれる。利用者への影響がある状態、調査が必要な状態、経過を見る状態を分け、それぞれに受け手と対応時間を決める。継続時間や複数条件を設定できる場合は、実際の障害を見逃さないか確認しながら調整する。
データが届かない状態の扱いも必要だ。値が正常なのか、エージェントや通信が止まり値を取得できていないのかは別である。欠損時に通知するか、メンテナンス中はどう扱うかを決める。CloudWatchの公式説明も欠損データの扱いに触れている。
監視対象と同じ基盤、同じネットワーク、同じ通知経路だけに依存すると、その基盤の障害で監視も通知も止まることがある。重要なサービスでは外部からの応答確認や別経路の連絡手段を用意し、実際に届くか試したい。障害時の社外向け連絡は障害情報の伝え方も参考になる。
AIによる要約や原因候補は、調査の出発点として使う。候補に挙がった時刻のログ、メトリクス、トレース、直前の変更履歴を確認し、観測できた事実と推測を分ける。複数の異常が同時に出ても、一方が原因とは限らない。復旧操作は権限と影響を確認した担当者が判断する。入力するログに機密情報がないか、保存先と利用条件も事前に確かめる。AIOpsの使いどころも参照できる。
候補を同じ条件で試すには、開始前に対象と合格条件を書き出す。ダッシュボードがきれいに見えるかだけでなく、担当者が通知を受け、必要な情報にたどり着けるかを確認する。
試用が終わったら、検知漏れ、過剰通知、担当者の負担、必要な費用を並べて判断する。費用を減らすためにログや保持期間を削る場合は、削った結果どの障害が調べられなくなるかまで確かめたい。
導入後も、監視対象が増えたときには設定を見直す。新しいサービスを公開したのに監視対象へ登録されていなければ、既存の画面が正常でもそのサービスの停止は分からない。サービスの追加・廃止時に、監視ルール、通知先、保存期間、担当者を確認する手順を決めておく。
定期点検では、通知が多い項目を単に止めるのではなく、何を守るための通知かを確認する。対処の不要な通知は条件を見直し、実際に対応が必要な通知は担当と手順を更新する。担当者の異動や連絡先の変更も、試験通知を通じて確認したい。変更後に誰が受け取るか、代理者まで含めて記録しておく。
夜間や休日の当番交代まで整えるなら、障害通知・インシデント管理ツールの比較で通知先と未応答時の引き継ぎを確認する。データを戻す備えはバックアップ・災害復旧サービスの比較で、監視とは別に選びたい。
Zabbixのソフトウェアはライセンス料なしで利用できる。ただし、監視サーバーや保存先、更新、保守の費用は別に見込む。クラウド型の無料枠も対象機能や量、期間を確認する必要がある。
監視は状態を集めて異常を判断すること、通知はその結果を担当者へ届けることである。通知先や対応時間が決まっていなければ、異常を検知しても対応につながらない。
サーバー監視はCPUやメモリなど基盤の状態を見る。APMはアプリケーションの応答時間やリクエストの流れなどを調べる。基盤が正常でもアプリが遅い場合があるため、必要に応じて組み合わせる。
利用環境と必要な監視範囲による。単一クラウド中心なら標準サービスを候補にできるが、他環境を横断した調査や独立した外形監視が必要なら、その範囲と追加費用を確認する。
原因候補として扱い、該当時刻のログ、メトリクス、変更履歴と突き合わせる。根拠が足りなければ保留し、復旧操作は影響と権限を確認した担当者が判断する。