Claude Managed Agentsのセルフホストは、AIエージェントの実行を管理するサービスや作業環境、セッション履歴を、自社のクラウドやオンプレミスに置く方式である。Anthropicは2026年11月12日にprivate betaを発表した。以下は2026年11月15日時点の公開資料に基づく解説であり、配布物を使った実機検証は行っていない。Anthropicの発表
自社に置けるのはエージェントの管理・実行基盤であり、Claudeのモデル本体は選択した推論先で動く。推論の際には会話やツールの結果がその提供先に送られる。履歴を自社で保管したい場合や、社内システムへの接続を管理したい場合に検討できるが、何も外部に出ない構成を意味しない。データとアクセスの公式説明
要点
- 管理サービスと作業環境、履歴は自社に置けるが、会話やツール結果は選んだ推論先へ送られる。
- private betaであり、利用条件と料金は個別に確認する。公開料金のsession-hour単価が自社運用にも適用されるかは確認できていない。
- 導入前に保存先、接続先、権限に加え、監視・更新・復旧を担当する人を決める。
Claude Managed Agentsとは?
Claude Managed Agentsは、長時間かかる仕事を非同期に進めるAIエージェントのための基盤である。依頼を受けてモデルへ問い、必要に応じてツールを動かし、その結果を踏まえて次の処理へ進む。この繰り返しを支えるのがagent harnessで、利用者はAPIを通じて仕事の開始や状態の確認を行う。モデルへ一回だけ質問する呼び出しとは異なり、途中の処理や待ち時間を含めて扱う。Managed Agentsの公式概要
基本となるのは、振る舞いや利用可能なツールを定めるAgent、実行に必要な環境を表すEnvironment、個々の仕事を進めるSession、進行状況を示すEventsである。sandboxはコマンドやファイル操作を行う作業場所だ。例えば資料を読み、複数のファイルを確認して報告案を作る仕事なら、セッションを作って処理を進め、イベントから経過を確認する。
Claude Codeは開発作業を支援する製品であり、Managed Agentsはアプリケーションなどからエージェントのセッションを管理するための基盤である。セルフホスト版をClaude Codeそのもののサーバー版と考えると、用途を取り違えやすい。公式の製品案内もClaude Codeをコーディング作業の委任先として説明している。モデル、ハーネス、スキル、MCPの担当範囲はハーネス・スキル・MCPの関係で確認できる。
3つのホスト方式は何が違う?
選ぶときは「自社で動く」という一言ではなく、管理サービス、sandbox、推論を別々に見る。次の3方式は、どこを誰が管理するかの整理である。自社運用の公式概要と環境の選択ガイドを参照した。
| 方式 | 管理サービスと履歴 | ツールの作業場所 | 推論 |
|---|---|---|---|
| 全面ホスト | Anthropicがホスト | Anthropic側の環境 | Anthropic側で実行 |
| sandboxだけ自社 | Anthropicのサービス | 自社が管理するworker側 | Anthropic側で実行 |
| サービスも自社 | 自社のサービスとデータベース | 自社が管理するworker側 | 選択したClaudeの推論先 |
sandboxだけを自社に置く方式では、作業場所のファイルやプロセスはworker側に残る。ただし会話やツールの結果はAnthropicのサービスに送られる。サービスも自社に置く方式は、履歴や管理サービスまで自社側に移す点が違う。どちらも「Claudeモデルを自社サーバーへ設置する」という意味ではない。
全面ホストは自社で管理する範囲を小さくしたい場合の候補になる。sandboxだけ自社に置く方式は、作業場所や社内接続を自社で管理したい場合に、サービスも自社に置く方式は、履歴や管理基盤の保管場所も管理したい場合に検討しやすい。その分、構築や障害対応の役割は自社に増える。
自社に置くサーバー、DB、workerの役割
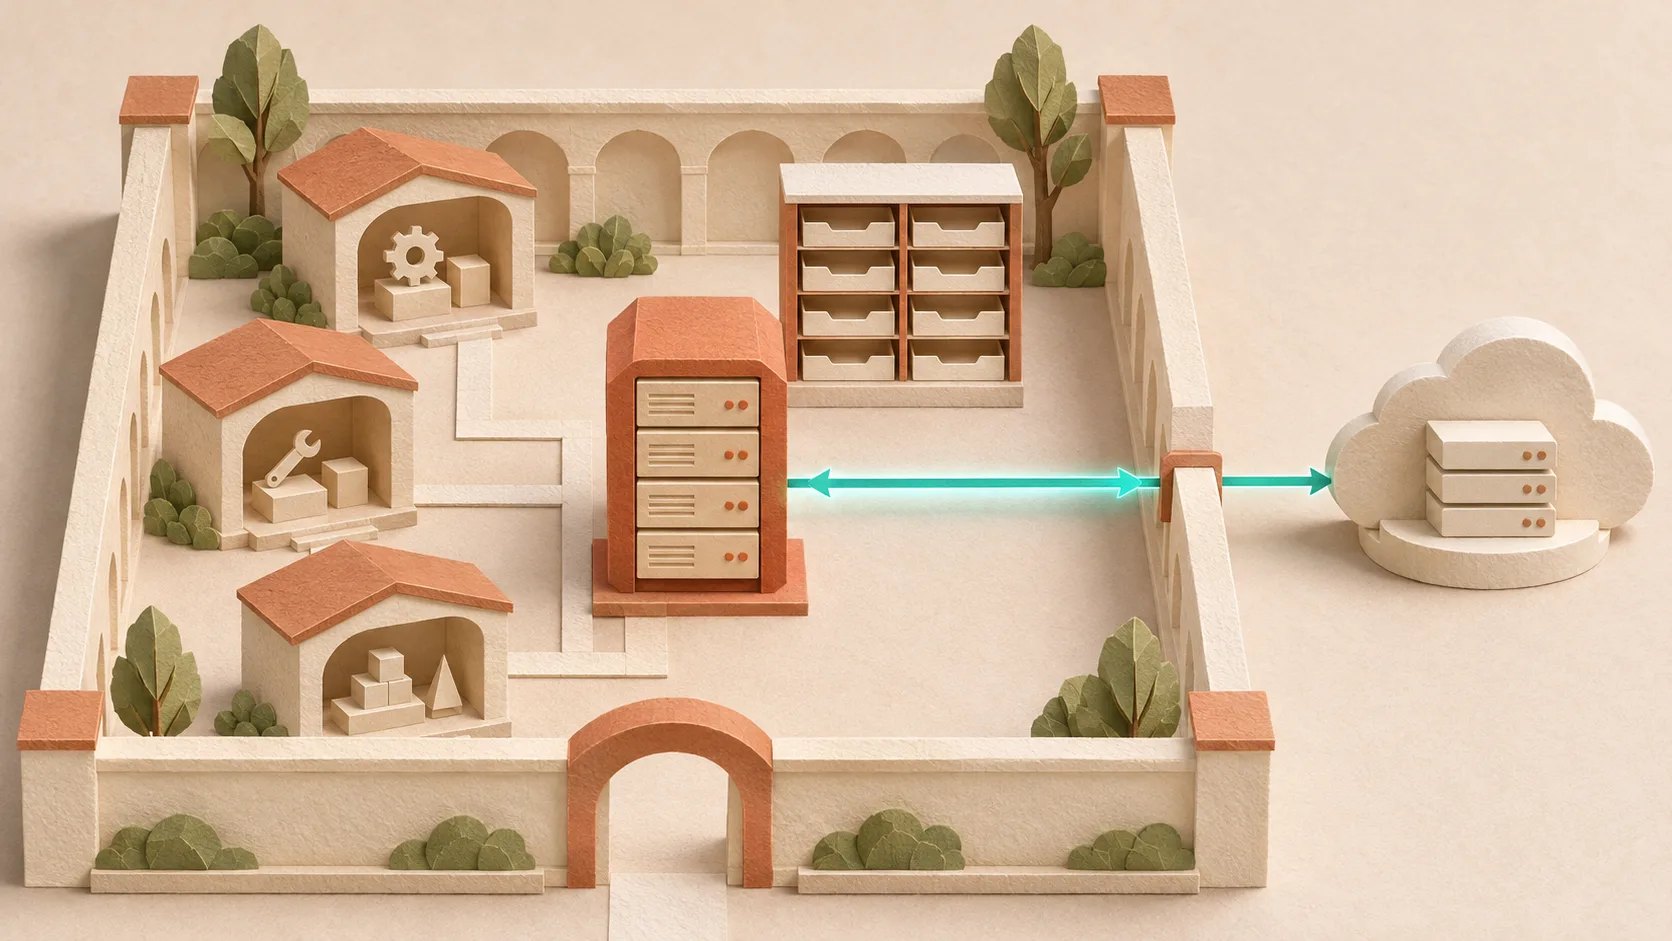
サービスも自社に置く構成では、cma-serverがAPIを受け、モデルとのやり取りやツール呼び出しを進める。workerはsandboxの中でシェルやファイルに関するツールを実行する。セッションの履歴などはPostgreSQLに保存でき、公式資料はPostgreSQL 16以降を挙げている。保存先を設定しない場合の既定値はメモリであり、再起動でデータが失われる。構成の公式説明と設定リファレンス
例えば担当者がAPIから資料整理を依頼すると、サーバーがセッションを管理し、必要な処理をworkerへ渡す。workerがファイルを読み、その結果をサーバー経由で推論先へ渡し、モデルが次の処理や回答を決める。ここで自社の中に置くサーバーと、文章を生成するモデルは別の場所にある。社内ネットワークにサーバーを設置しても、推論先へ出る通信がなくなるわけではない。
履歴のDBと、sandbox内の作業ファイルも別に管理する必要がある。Kubernetesの標準構成では、セッションごとのworkspace volumeがpodの終了後も残り、既定では保持される。保存期間や削除を決めずに始めると、処理が終わった後も作業ファイルが残り得る。DBのバックアップだけでファイル側の保管・削除まで済むとは考えない。Kubernetes配備ガイド
外部へ送る情報と、自社に保存する情報
推論を行うたびに、プロンプトや会話、ツールへの入力と結果が、利用するモデル提供先へ送られる。例えば社内文書を検索して得た本文をツール結果としてモデルへ渡すなら、その本文も送信対象になる。元ファイルを自社のストレージに置くだけでは、内容が外へ送られない保証にはならない。データとアクセスの公式説明
履歴を自社DBに保管することと、推論先のデータ保持条件は別の話である。Anthropicとの既存のZero Data Retention(ZDR)合意がある場合、公式資料はMessages APIと同様に推論へ適用されると説明している。自社ホストに切り替えれば自動的にZDRになるわけではない。どの提供先を使うかによって適用条件や契約を確認する必要がある。
同様に、自社サービスを日本国内に置くことと、推論処理のリージョンや提供先での保存場所が国内に限定されることも別である。処理場所、保存期間、ログ、再委託先について、選ぶ推論先と契約ごとに確認したい。管理する場所とデータの扱いを分けて考える視点はソブリンAIの解説にもつながる。
導入前には、入力する指示、検索結果、ツールが返すエラー、生成した文書のうち、何が推論に含まれるかを仕事ごとに洗い出す。顧客名を送れない業務なら、伏せ字にする仕組みと、そのまま送信されないかをテストする。社内に保存するデータにも閲覧権限、保存期間、削除方法が必要だ。
推論先は選べるが、任意のモデルに交換できるわけではない
公式の設定資料には、Anthropic、Amazon Bedrock、Google Cloudが管理するClaude Models、Microsoft Foundry、自社gatewayが選択肢として挙がる。自社gatewayを挟む場合は、対応するClaude系リクエストの形式を受けられる必要がある。gatewayを使えることは、任意の他社モデルへ自由に交換できる保証ではない。推論先の公式ガイド
すでにクラウドの契約や通信経路がある企業でも、利用可能なClaudeモデル、リージョン、ツールへの対応、認証方式は提供先ごとに確認する。特に、求める機能があることと、必要な地域・契約で利用できることは別の条件だ。候補を一つに決める前に、機密情報を送れる範囲と障害時の連絡先を社内の契約担当者と確かめたい。
認証とセキュリティはどこまで自社で担う?
自社ホストの構成では、次の3種類の認証情報を分けて扱う。自社ホストの認証の説明
| 認証情報 | 用途 |
|---|---|
| server API key | アプリやCLIが自社のManaged Agents APIにアクセスする |
| inference credential | サーバーが推論先を利用する |
| environment key | workerが特定環境のqueueをpollし、結果を返す |
MCPなどの業務接続先に対する認証は、この3種類とは別に管理する。
SSOとユーザー権限
OIDCを使えば、認証基盤のグループをadmin、developer、userのロールへ対応付けられる。server API keyはadmin権限を持つため、通常の利用者に共通で配る鍵として扱わない。公式のロール説明ではdeveloperとuserのアクセスは同じで、自分のリソースを扱い、すべての環境でセッションを実行できる。SSOに接続できることやuserロールがあることだけを根拠に、環境ごとの細かな権限制御が実現できるとは考えない。OIDCとロールの設定
自社用consoleは同じ自社APIに接続し、agentやsessionなどを画面から扱える。Anthropicのplatform.claude.comのConsoleとは別であり、外部からアクセスさせる場合はOIDCとHTTPSを含む保護を設定する。自社consoleの公式説明
接続先の鍵と通信を分ける
agent identityを使う構成では、エージェントごとの短命なJWTを接続先のMCPサーバーで検証できる。secret managerと組み合わせて接続先の認証情報を管理する方法や、egress gatewayでsandboxからの通信先を許可したホストに絞る方法も用意されている。gatewayは既定でオフであるため、有効化と許可先の設定が必要だ。agent identityの公式ガイド
例えば経費データの検索だけが必要なら、接続先に必要最小限の読み取り権限を与える。業務に関係のない社内サーバーや外部サイトへもworkerが到達できる状態のまま、「sandboxがあるから大丈夫」と判断しない。通信先の制限、鍵の保管、ツールの実行権限は導入者が具体的に設定する。
ツールの実行許可も確認したい。公式のpermission policyでは、always_allowは自動許可、always_askは人の承認待ち、autoはサーバーが許可・拒否・確認を判断する。agent toolsetの既定はalways_allow、MCPはalways_askで、custom toolsはこのpolicyの対象外である。外部送信など人の確認が必要な操作にはalways_askを検討し、custom toolsはクライアント側の判断方法を別に用意する。autoだけで人の確認が必ず入るわけではない。ツールの許可ポリシー
テナントと信頼レベルで分ける
公式資料は、一つのdeploymentを一つのテナントと信頼レベルに対応させ、別のテナントにはDB、鍵、workerを含めて分離するよう案内している。社内の異なる部署をどう区切るかも、扱う情報と信頼関係に応じて検討する。ログインのグループ分けだけを、実行環境やデータの分離と同一視しない。テナント分離の公式説明
サービスも自社でホストする場合、サービス全体の隔離をAnthropicが担うと考えてはいけない。sandboxの境界は同じsandbox内のツール同士を個別に隔離するものでもない。実行環境の強化、マウントする領域、通信制限、鍵や履歴の保護を自社で確認する。sandboxのセキュリティモデル
hosted版との機能差:API互換でも機能は同じではない
セルフホスト版はAPIの使い方に共通点があるが、hosted版の全機能がそろうという意味ではない。次は2026年11月15日時点のベータ資料に基づく主な差であり、今後変わり得る。移行前には使いたい機能を個別に照合する。hosted版との違い
| 機能 | セルフホスト版で確認した条件 | 導入時に見る点 |
|---|---|---|
| 定期実行・webhook | scheduled deploymentsとwebhooksは未対応 | 定期起動や完了通知を別に用意する |
| ファイルと組み込みSkills | Files APIとdocx・pdf・pptx・xlsxの組み込みSkillsは未対応 | 必要なファイル受け渡しとカスタムSkillを用意し、動作を試す |
| MCPのOAuth | 自動refreshは未対応 | 接続先の認証更新を別途管理する |
| 複数エージェント | 事前定義した1〜20のエージェントをcoordinatorが扱う方式 | 想定する分担と上限が合うか確かめる |
| Web検索・取得 | 設定と推論先に依存 | 使うモデルと通信先で対応を確認する |
URLで指定した画像やPDFは受け付けられてもモデルに届かない制約が公式資料に記載されている。回避するには、画像はbase64、文書はbase64かtextで渡す。既存アプリがURLを渡して画像を読ませている場合、APIがエラーを返さないだけでは内容を読めた証拠にならない。実際に必要な入力を使い、結果とイベントを確認する。ツール待ちの仕組みもworkerのpollingを含めて対象環境で確かめたい。
private betaへの参加と、開発・本番の準備
公開発表ではprivate betaへの参加についてAnthropicの担当窓口へ問い合わせるよう案内している。配布物もアカウントチームへ申請する。誰でも直ちに利用できる一般提供として計画せず、対象条件、提供時期、契約、サポート範囲を確認する。発表とQuickstart
開発用のQuickstartは、1台のマシンでDocker Composeを使い、サーバー、PostgreSQL、workerを起動する構成である。セッションごとにsandboxコンテナを使う。HTTPは平文で、公式ガイドは保護すべきデータのないマシンでの利用を案内している。ローカルで動いた構成をそのまま社内の本番サービスとして公開しない。
本番には、リリースに同梱されるHelm chartを使ったKubernetes構成が推奨されている。到達可能なPostgreSQL、sandbox runtime、NetworkPolicyを適用できるネットワークなどを別途用意し、外部向け通信にはTLS終端を設ける。必要なクラスタや通信の条件はKubernetes配備ガイドで確かめる。
更新と復旧の担当者を先に決める
本番で必要なのは初回の構築だけではない。サービスやDBの監視、sandboxとボリュームの残存確認、鍵の更新、障害時の復旧を誰が行うかを決める。利用部門がエージェントを作れても、基盤が止まったときに対応する担当がいなければ仕事は続けられない。
公式の更新手順では変更履歴を確認し、minorやmajor更新などではDBをバックアップする。会話を含むDBのバックアップは暗号化し、認証情報を暗号化する鍵も復元できる場所に保管する。DBを戻すrollbackでは、バックアップ開始後の書き込みが失われる場合がある。更新時間だけでなく、復旧時にどこまで仕事をやり直すかも決めておきたい。更新と復旧の公式手順
料金は?公開単価、ライセンス、運用費を分ける
Anthropicの公開料金ページは、Managed Agentsについて標準のトークン料金に加え、稼働中のruntimeを1 session-hourあたり0.08ドルと掲載している。これはhosted向けの公開料金として確認できる数字であり、この記載だけでセルフホストにも同じ単価が適用されるとは判断できない。調査した公式資料だけでは、自社に適用される個別契約条件を確定できないため、問い合わせ時に確認する。
サーバーのソフトウェアライセンスには、条件付きでバイナリをroyalty-freeで利用できる旨がある。ただしモデル利用の契約や料金は別であり、ソフトウェアのライセンスと推論がすべて無料になるという意味ではない。改変や第三者モデルの利用などにも制限があるため、自社の予定する使い方と契約を照合する。
同ライセンスには、指定された安全更新を1営業日以内に適用することや、通知された無効化・rollbackを8時間以内に行うことなどの条件もある。具体的な義務や適用は契約担当者が原文と個別契約を確認する。休日を含む対応体制や更新手順を検討する材料になる。
加えて、自社のサーバーやKubernetes、DB、ストレージ、通信、監視、バックアップ、保守担当者の費用がかかる。見積もりでは、ソフトウェアの契約条件、モデルのトークン利用、基盤と人の費用を別々に置く。hosted版の単価だけを見て自社運用の総費用を比較すると、更新や復旧の負担が抜けやすい。
どんな業務に向く?小さく試す例
例えば、経理担当者が社内規程と申請内容を照合し、確認が必要な項目を一覧にする仕事を考える。規程の検索先と申請データは社内で管理し、エージェントは必要な範囲を読み取り、根拠となる規程の箇所とともに確認案を作る。承認や支払いは人が行う。これは検討用の例であり、実際の導入事例や効果の実測ではない。
この仕事で確かめるべきなのは、申請情報のどの項目が推論先へ送られるか、参照した規程が最新版か、別の部署の申請を読み取れないか、結果と作業ファイルがどこに残るかである。経理担当者が内容を確認し、開発担当者が接続権限とログ、基盤担当者が保存期間と復旧を確認する。金融分野のように扱う情報や権限の制約が大きい場合の論点はClaudeの金融向けエージェントも参考になる。
向いているのは、履歴の保管場所や社内システムへの接続を自社で管理する必要があり、推論先への送信も承認でき、基盤を維持する担当がいる場合だ。反対に、情報を一切外に送れない場合は、公開資料にある外部推論の仕組みと合わない。管理者や更新体制を確保できず、hosted版で必要な条件を満たせる場合も、自社運用を急ぐ理由は薄い。
検証を始めるときは、実行前の条件と終了条件を一つずつ決めておく。経費の例なら「承認済みの架空申請を渡し、規程にない支出は不明として残す」「結果には参照した規程の箇所を添える」といった条件である。正しい例だけでなく、規程に該当項目がない例、読めるはずのない部署のデータを求める例、接続先が応答しない例も用意する。
確認後は、経理担当者が根拠と判断を照らし、開発担当者が送信された情報とエラーを確認し、基盤担当者が履歴とworkspaceの保存・削除を確認する。実データへ広げる前には、担当者が困ったときに停止できるか、誤って処理した場合に何を戻すかも決める。モデルの回答が自然に見えることだけで、接続権限や復旧まで検証できたことにはならない。
よくある失敗と確認方法
よくあるのは、テストデータでは成功した後、本番の検索結果に顧客情報が含まれると分かるケースである。検索ツールの結果をモデルへ送る前提を把握せず、保存先だけで安全性を判断してしまう。最初に架空データで通信と出力を確認し、実データを使う前に送信項目を承認する。
もう一つは、APIが動いたのでhosted版の機能もすべて動くと考え、定期実行やファイルの受け渡しが後から足りなくなるケースだ。業務の開始から担当者の確認までを一通り書き出し、未対応機能の代替、失敗時の通知、再実行時の重複を先に試す。結果の正しさだけでなく、意図しない接続を拒否できるかも確認する。
よくある質問
セルフホストなら情報を外部に送らずに使える?
送らずに使えるとはいえない。モデルは選んだ推論先で動き、推論の際には会話やプロンプト、ツールの入力と結果が提供先へ送られる。
オンプレミスにClaudeのモデル本体を置く仕組み?
自社に置くのは管理サービスやsandbox、履歴などである。Claudeの推論は選択したモデル提供先で行う。
セルフホスト版の料金は無料?
バイナリのライセンスには条件付きのroyalty-free利用が記載されるが、モデル利用料金や自社の基盤・保守費用は別である。個別の契約条件は問い合わせて確認する。
公開されている0.08ドルの単価はセルフホストにも適用される?
公開料金ページにはManaged Agentsの稼働中runtimeの単価が掲載されているが、その記載だけではセルフホストへの同一単価の適用を確認できない。
hosted版と同じ機能をすべて使える?
同じとは限らない。2026年11月15日時点のベータ資料では、定期実行やwebhook、Files APIなどに差がある。必要な機能を個別に確認する。
SSOを設定すれば部署ごとに完全に分離できる?
SSOだけで分離できるとはいえない。公式資料はテナントと信頼レベルごとにdeploymentを分け、DBや鍵、workerも分離するよう案内している。
利用するには何から始めればよい?
一つの業務について保存先・送信内容・接続先・担当者を整理し、Anthropicの担当窓口にprivate betaの参加条件を問い合わせる。
まずは一つの業務について、保存先・送信内容・接続先・担当者を整理し、Anthropicの担当窓口にprivate betaの参加条件を問い合わせる。推論先の契約と、社内で更新・復旧を担う人まで確認できれば、採用するかを具体的に判断しやすい。