要点
- 顧客の知識ベース、ツール、方針を使い、エージェントと動作環境を再現する。
- 敵対的な利用者を含む大量の模擬対話で、誤回答、誤操作、情報漏えいなどを検証する。
- 修正案を生成して再試験し、模擬データを使った小型モデルで本番のやり取りも監視する。
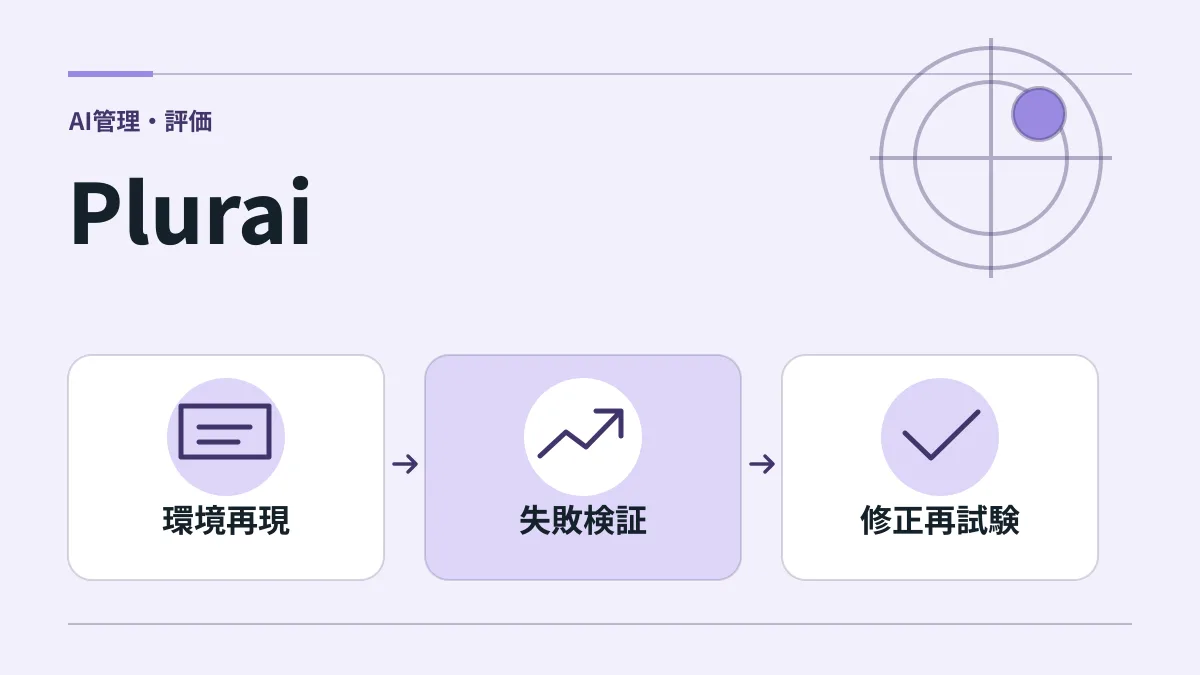
AIエージェントの検証では、正しく答えた例だけでなく、誤った操作や方針違反が起きる条件も探す必要がある。Pluraiは、エージェントとその動作環境を再現し、多数の模擬ユーザーを使って本番投入前の挙動を試すプラットフォームである。顧客対応など、対話とツール操作が組み合わさる業務を検証対象にできる。
入力には、顧客自身の知識ベース、利用するツール、業務方針を使う。それらを基に、AIエージェントと環境のデジタルツインを構築する。一般的な質問集だけで試すのではなく、実際の業務で参照する情報や操作対象を含めた環境を用意する流れだ。
サンドボックスでは、数千の模擬ユーザーがエージェントに働きかける。一部には意図的に敵対的な利用者も含まれる。検出対象は、方針違反、事実にない回答、誤った行動、ツール呼び出しの不具合、タスクの未完了、機密情報の漏えいである。回答文の正しさに加え、業務をどう進めたかも試す。
見つかった失敗に対して修正案を生成し、再びシミュレーションを実行する。修正が効いたかと同時に、新たな問題を引き起こしていないかを確認する工程である。例えば、顧客から例外的な依頼を受けた際に、業務方針に反する処理をしないかを試す使い方が考えられる。これは検証例であり、特定業種の試験項目が標準搭載されていることを示すものではない。
開発者はClaude Code、Codex、GitHub Copilot、Cursorなどの開発ツールから利用でき、Salesforce Agentforceで構築したエージェントの検証にも対応する。既存の開発作業へ検証を組み込みたい場合の接点となる。
シミュレーションデータを使い、エージェントごとに小型言語モデルを訓練する機能も持つ。このモデルは本番環境で各やり取りを確認する監視役となる。抽出した一部の対話だけを評価する運用に対し、全やり取りを確認する構成を取る点が特徴である。
導入前には、知識やツールをどこまで再現できるか、模擬ユーザーが実際の顧客行動を覆うか、修正案をどう確認して適用するかを確かめたい。本番監視の検出結果を誰が確認するかも決める必要がある。発表された改善実績は製品側の報告値であり、自社環境の結果とは区別すべきだ。料金や日本語での検証条件は個別の確認事項となる。