要点
- doccはPyTorch、NumPy、C/C++のコードをデータフロー表現へ変換し、対象チップ向けのコードを生成する。
- AIエージェントが実機で最適化を探索し、コンパイラが正しさを確認した結果を再利用する。
- Daisyflowは複数種のモデル配信、バッチ処理、ルーティング、OpenAI互換APIを扱う。
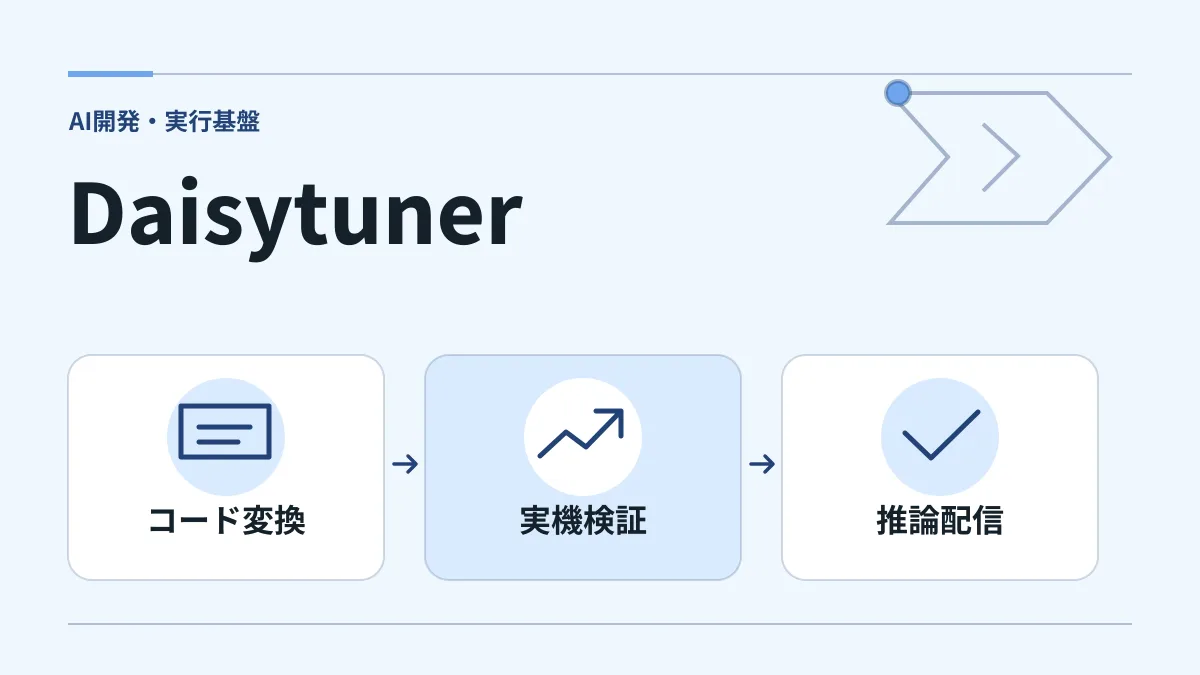
AIモデルやプロセッサーを変更すると、それまで有効だった実行上の最適化がそのまま使えるとは限らない。Daisytunerは、この調整を自動化するコンパイラと推論エンジンを提供する。コードの変換と実機での検証を担うdoccに、モデルを配信するDaisyflowを重ねた構成である。
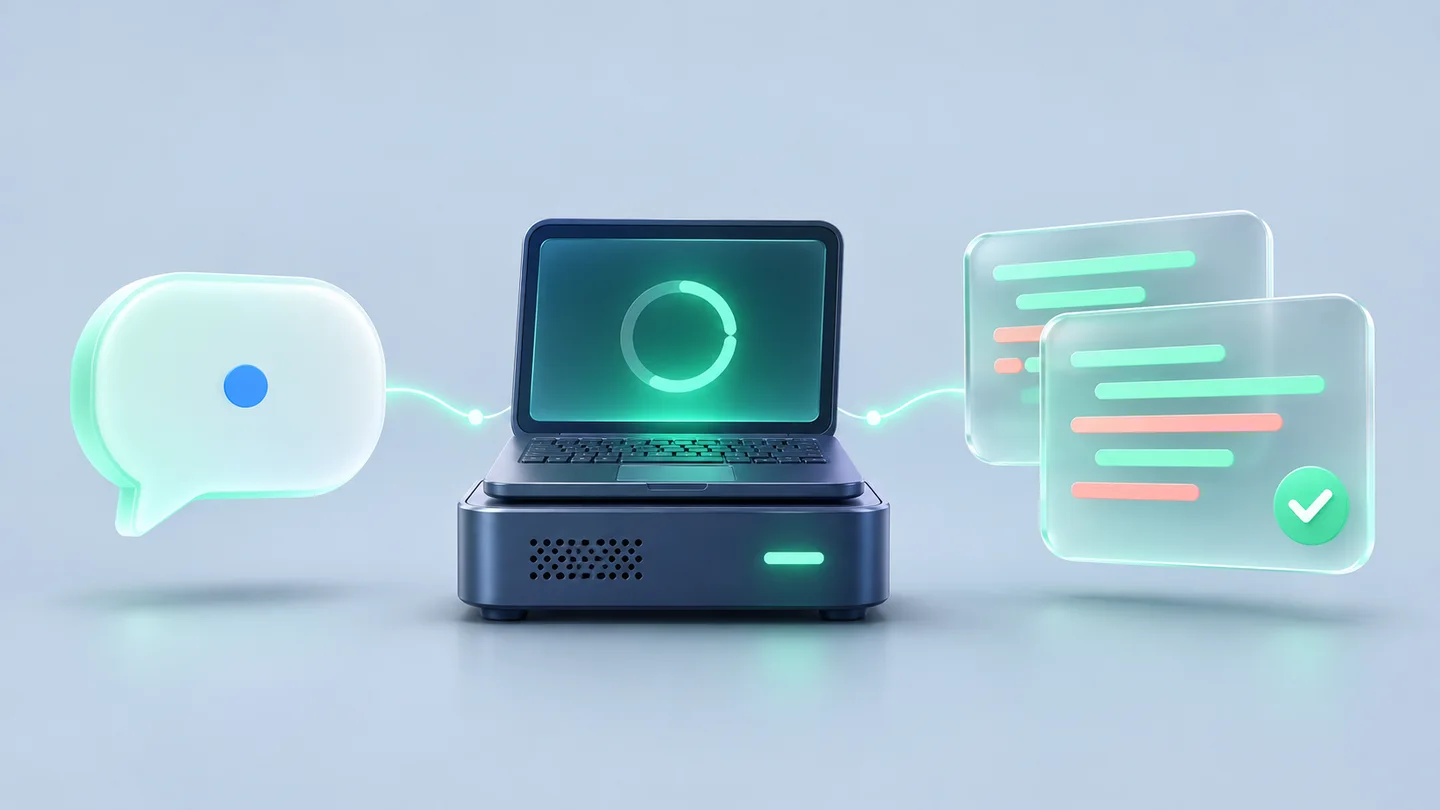
オープンソースのコンパイラdoccは、PyTorch、NumPy、C/C++で書かれたコードをデータフロー表現に変換する。その後、CUDA、ROCmや新しいチップ構成に向けたネイティブコードを生成する。入力コードを対象ハードウェアに合わせた実行へつなぐ工程だ。
AIエージェントは最適化の候補を探し、実際のハードウェア上で試す。変更を採用する前にコンパイラが正しさを確認し、検証した最適化を性能データベースへ保存する。似たコードに結果を再利用するため、モデルやチップが変わるたびに手作業で調整をやり直す負担を扱える。
Daisyflowは、その上に推論の配信機能を加える。言語、画像、音声、推薦のモデルを扱い、バッチ処理、ルーティング、OpenAI互換APIを備える。コンパイルで実行を調整する工程と、利用側からの要求を受けてモデルを動かす工程をつなぐ仕組みである。
例えば、異なるGPUを持つ環境で言語モデルを運用する場合、各実機で実行性能を確かめたうえで、配信側のバッチ設定や要求の振り分けを検討する。OpenAI互換APIを使う場合も、既存アプリが利用するAPI項目とモデルの挙動が適合するかを確認する必要がある。
異なるハードウェアを持つクラウド環境、自社でデータを管理しながらモデルを動かしたい企業、新しいチップを実運用へ投入したい開発側が想定対象である。提供形態にはホスト版と、サービス水準合意を伴うセルフホストの企業向け版がある。
導入時は、対象モデルの演算やコードが対応する範囲、利用するGPUと実行環境、最適化を探索するための実機資源を確認したい。性能評価では、自社の入力長、同時要求数、バッチ条件で遅延と処理量を測ることが重要だ。公表されたQwen 2.5の独自比較結果だけで、別モデルや別チップでも同じ改善が出ると判断することはできない。数値の正しさと配信性能を、自社の負荷で一緒に確かめる必要がある。