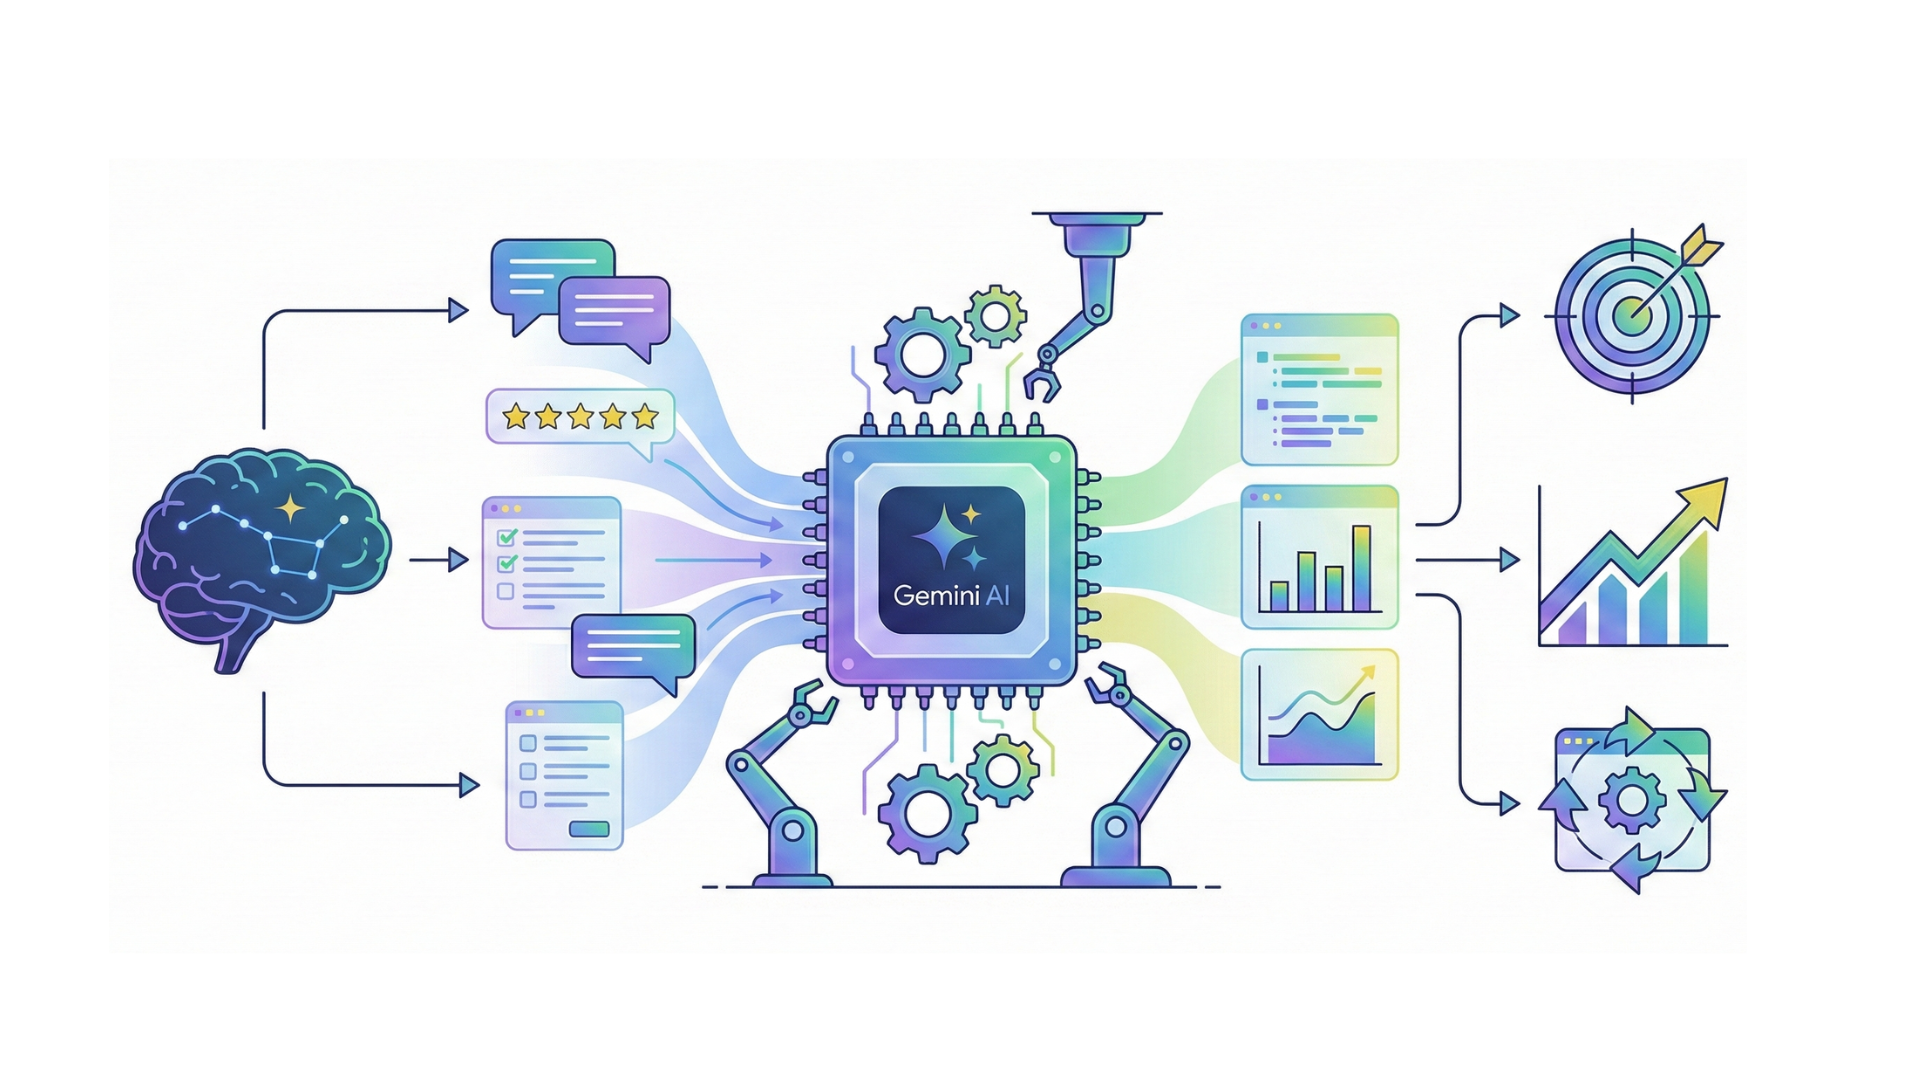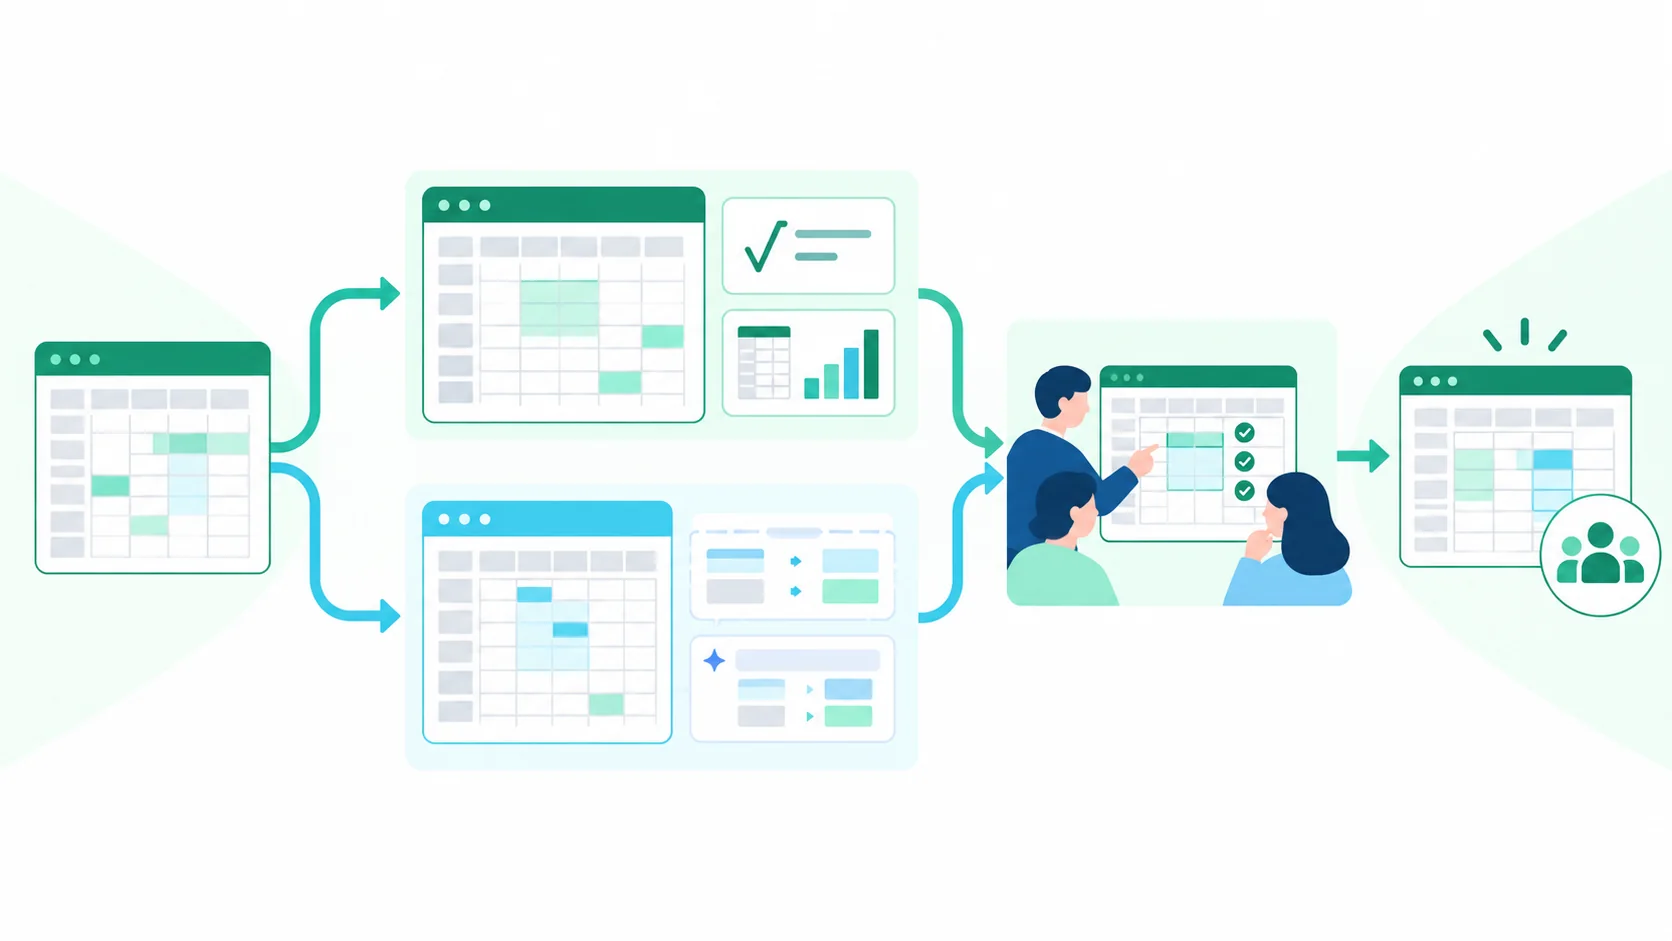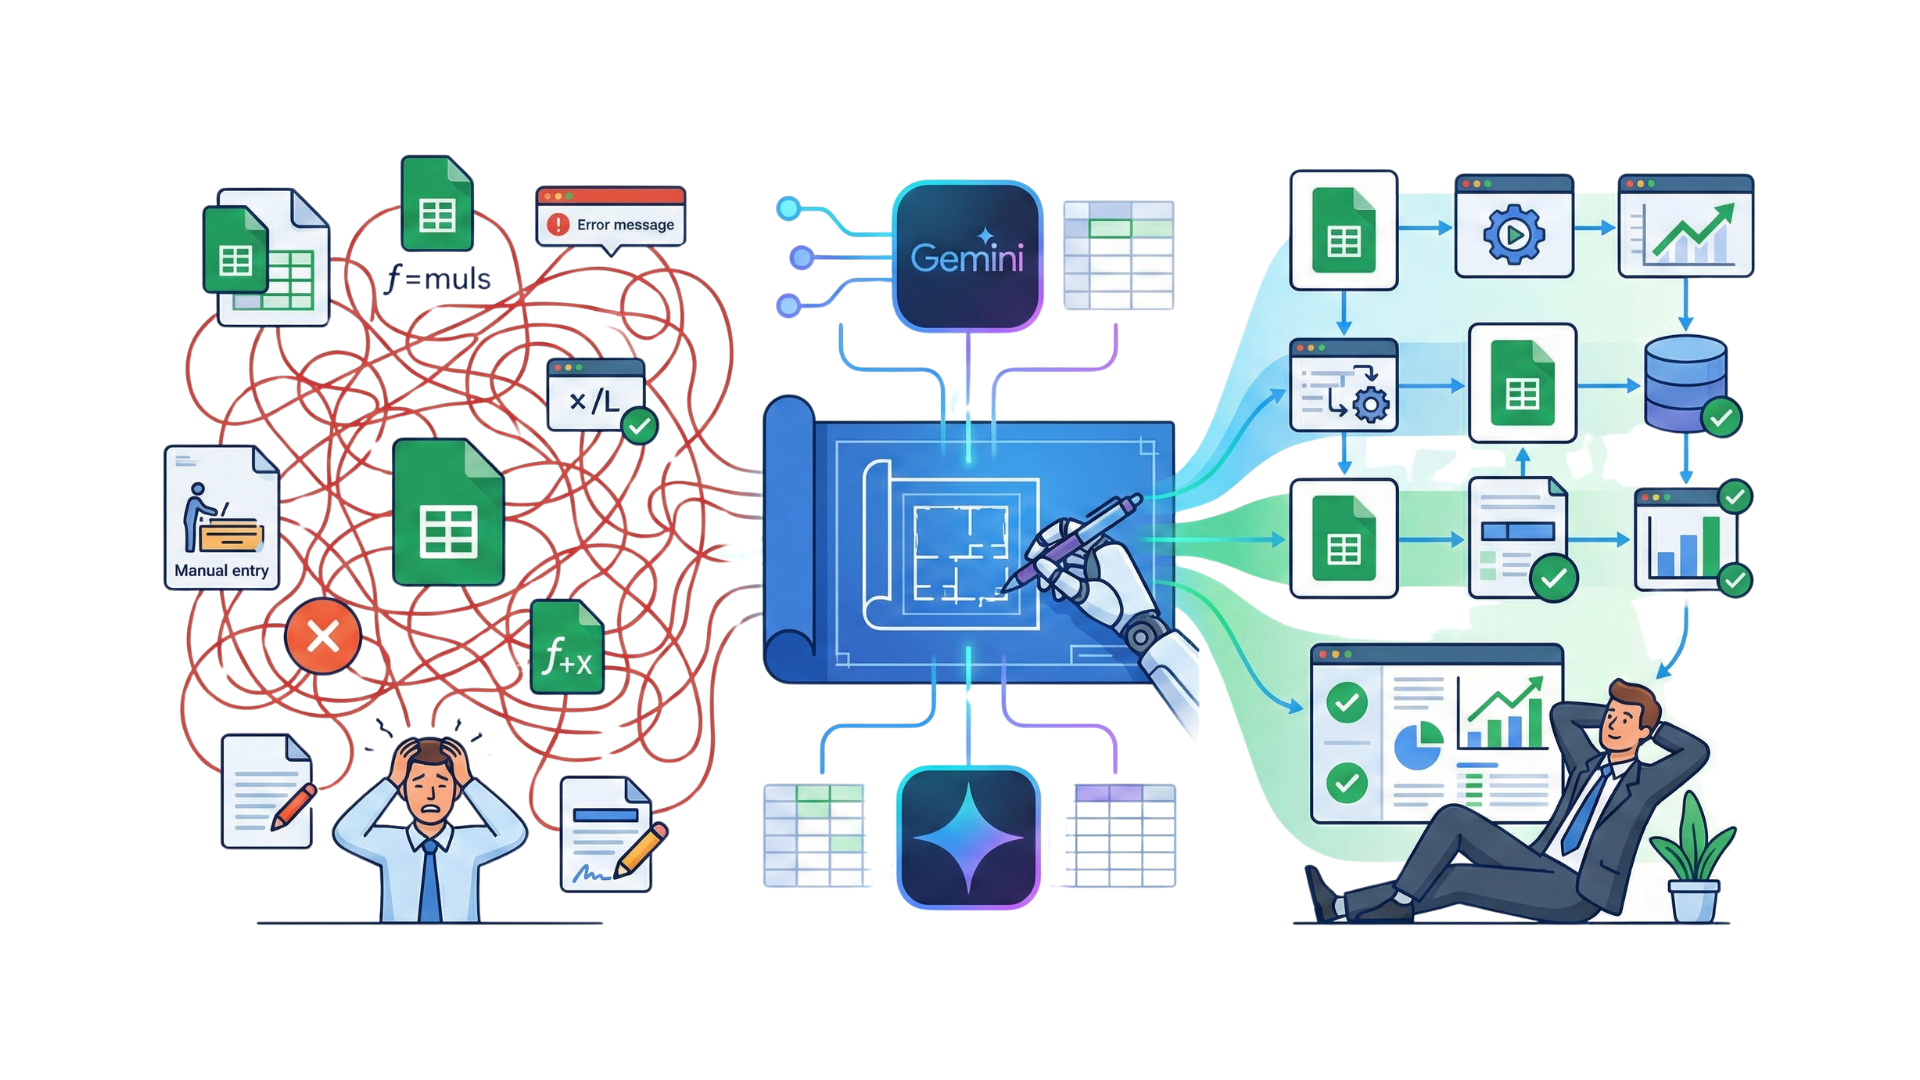
GoogleスプレッドシートのAI関数(=AI() / =Gemini())を業務で使うときは、AIの出力を確定値として使わず、専用の列に置いた「下書き」として扱います。AI列の出力を通常の関数で分解し(Parse)、許容値や空欄を検証し(Validate)、合格した行だけを人が確定する(Final)3段階にすると、結果がぶれても集計や転記は壊れません。AI関数は出力がテキストのみで、入れ子にできず、1回に生成されるのは350セルまでなので、この3段階とバッチ運用を最初から前提にします。
そのまま使うと、集計できない、結果がぶれる、再生成で全行が変わるといった問題が起きやすくなります。機能の一覧と活用例は、GoogleスプレッドシートのAI関数の使い方・できることで扱っています。制約と上限は、2026年10月27日時点のGoogleスプレッドシートのAI関数ヘルプに基づきます。
要点
- AI関数の出力は確定値ではなく下書きとして専用列に置き、Parse・Validate・Finalの3段階を経た値だけを集計や転記に使う。
- 出力はテキストのみで入れ子にできず、1回に生成されるのは350セルまでのため、分解・検証は通常の関数で行い、生成は350行以内のバッチで回す。
- 再生成はvalid_okがFALSEの行とプロンプトの版を上げたときに限り、確定済みの行は再生成せず、入力が変わったら新しい行として残す。
AI関数は「制約」を理解した瞬間に設計が決まる
最初に押さえるべきは、AI関数の制約です。ここを知らないまま作り込むと、後から高確率で崩れます。
Googleのヘルプで案内されている制約と、設計への影響は次のとおりです。
| 公式ヘルプの制約 | 設計への影響 |
|---|---|
| 出力はテキストのみ | 数値や構造は、後段の関数で分解・変換する(Parse列) |
| AI関数は入れ子にできない(IFで包むことも不可) | AI列は単独に置き、判定は別の列で行う(Validate列) |
| シート全体や他のDriveファイルは見えない | 判断に必要な情報は、範囲の引数で明示的に渡す(context列) |
| 1回に生成されるのは選択した最初の350セル | バッチ番号列を作り、350行以内ずつ生成する |
| 元に戻す・やり直しはできない | 確定値はFinal列に値として固定し、AI列の再生成で失われないようにする |
| 長期の上限に達すると24時間生成できない | 締め切り直前に大量生成しない。生成は前日までに済ませる |
このほか、生成結果は揺れるため、壊れた出力を検知して止める仕組み(Validate)が必要です。監査や責任分界のために、生成者・日時・プロンプト版も記録します。
結論として、AI関数は「1セルで完結させる魔法」ではなく、テキスト出力を中間生成物として扱うパイプラインにしたときに安定します。
設計原則:AIは1列で閉じる(AI列=中間生成物)
AI関数を運用に乗せるとき、いちばん壊れにくい基本形はこれです。
- Raw列:人や外部から入ってくる原文
- AI列:AI関数の出力(固定フォーマットで返させる)
- Parse列:通常関数で分解(SPLIT / REGEX / TRIM など)
- Validate列:チェック(空欄、許容値、範囲、長さ)
- Final列:確定値(レビュー後に値貼り付け等で固定)
- Audit列:生成日時、プロンプト版、生成者、レビュー状況
ここで重要なのは、AI列は“確定値”ではなく素材だと割り切ることです。
下流(集計・CRM転記・ダッシュボード)で使うのは、原則 Final列にします。
そのまま使える:列テンプレ(最低限これだけで安定する)
シート設計で迷ったら、まずはこの形をベースにしてください。
input_raw:原文(問い合わせ、議事録メモ、レビューなど)context_*:補足情報(商品名、顧客属性、カテゴリ候補、担当部署など)ai_out_v1:AI出力(フォーマット固定)parsed_label:分解後のラベルparsed_evidence:分解後の根拠parsed_score:分解後のスコアvalid_ok:検証結果(TRUE/FALSE)final_label:確定ラベル(人がレビューして入れる/値貼り付け)prompt_version:プロンプト版(v1/v2…)generated_by:生成者generated_at:生成日時review_status:未レビュー / OK / 差戻しreviewed_by/reviewed_at:レビュー履歴
出力フォーマットの“型”を先に決める(集計を壊さないため)
AI関数の返り値はテキストです。だからこそ、**後工程で扱いやすい“文字列の型”**を決めておくのが肝になります。おすすめは次の3つです。
型A:単一ラベル型(最も強い。まずはこれ)
出力例:不具合(1語だけ)
ピボットや集計が圧倒的に安定します。分類が主目的なら、まずこの型が鉄板です。
プロンプト例(スプレッドシート)
=AI(
                     "次の文章をカテゴリ分類してください。出力は候補から必ず1つだけ:不具合,要望,質問,解約,その他。迷ったらその他。出力はラベルのみ。",
                     input_raw
                    )
型B:「|」区切りの複数項目型(運用に強いおすすめ)
出力例:不具合|ログインできない|0.82
ラベルだけだとレビューで困ることが多いので、根拠や確信度まで欲しい場合はこの型が便利です。
区切り文字は、カンマより事故が少ない「|」を推奨します。
プロンプト例
=AI(
                     "次の文章を処理して『ラベル|根拠(15文字以内)|確信度(0〜1)』で出力してください。区切りは必ず|。欠損は不明。",
                     input_raw
                    )
型C:JSON“風”テキスト(上級者向け。崩れる前提で使う)
出力例:{"label":"不具合","evidence":"ログイン","score":0.82}
後段で正規表現抽出する設計なら使えますが、JSONを“常に正しく返してくれる”期待で運用すると壊れます。
最初の導入では、型Aか型Bに寄せた方が安全です。
Parse(分解)は関数だけで完結させる(型Bが強い理由)
型B(|区切り)にしておくと、分解が驚くほどシンプルになります。
たとえば ai_out_v1 が ラベル|根拠|確信度 のとき:
=IFERROR(INDEX(SPLIT(ai_out_v1,"|"),1),"")           /* parsed_label */
                    =IFERROR(INDEX(SPLIT(ai_out_v1,"|"),2),"")           /* parsed_evidence */
                    =IFERROR(VALUE(INDEX(SPLIT(ai_out_v1,"|"),3)),"")    /* parsed_score */
「区切りが無い」「途中で文章が混ざった」などの事故は必ず起きるので、IFERRORで受けるのが運用品質を左右します。
Validate(検証)で“止める”:AIの揺れはゼロにできない、検知できる
AIのブレを消すのではなく、壊れた出力を検知して止める。これが実務で一番効きます。
ラベルのホワイトリスト検証
別シートに許容ラベル一覧(例:allowed_labels)を置いて、これに入っているか確認します。
=COUNTIF(allowed_labels, parsed_label)>0
必須項目の空欄チェック
=AND(parsed_label<>"", parsed_evidence<>"")
確信度の範囲チェック(0〜1)
確信度が空欄や文字列のときに合格扱いにならないよう、先にISNUMBERで数値かどうかを確かめます。
=AND(ISNUMBER(parsed_score), parsed_score>=0, parsed_score<=1)
検証を1列にまとめる(valid_ok)
ラベル・必須項目・確信度の3つの検証を、valid_ok列にまとめます。
=AND(COUNTIF(allowed_labels, parsed_label)>0, parsed_label<>"", parsed_evidence<>"", ISNUMBER(parsed_score), parsed_score>=0, parsed_score<=1)
valid_ok=FALSE の行だけフィルタして、人がレビューする。
この流れを作るだけで「AIの結果が信用できない」という不安はかなり減ります。
Human-in-the-loop:レビューと確定(Final)を最初から作る
AI列の出力をそのまま下流に流すと、運用は高確率で破綻します。
おすすめは、最初から二段階にすることです。
- AI生成(ai_out_v1)
- 人がレビューしてFinal列に確定(必要なら値貼り付けで固定)
こうしておくと、後からRefreshで結果が変わっても、Final列が守られるので、下流(集計・報告・転記)が安定します。
再生成(Refresh)ポリシー:Refreshは“例外”にする
Refreshが便利だからこそ、無制限にやると現場は混乱します。
運用で決めておきたいのは「いつRefreshしてよいか」です。
再生成してよい状況と、そのときに記録することを次のように決めておきます。Googleのヘルプでは、離れた範囲をつなげたプロンプトは、範囲内のデータが変わっても更新を促されないと案内されているため、その場合は担当者が判断します。
| 状況 | やること | 記録すること |
|---|---|---|
valid_okがFALSE | その行だけ再生成する。再生成してもFALSEのままなら人が入力する | 再生成した日時と回数 |
| プロンプトを改善した | prompt_versionを上げ、新しいAI列(ai_out_v2)に生成する。古い列は消さない | 新旧の版と切り替えた日 |
| 入力(raw・context)が変わった | 再生成ではなく、新しい行として生成し、古い行は履歴として残す | 元の行への参照 |
| 離れた範囲をつなげたプロンプトを使っている | データが変わっても更新を促されないため、入力を更新したら担当者が再生成の要否を判断する | 判断した担当者と日時 |
| Final列が確定済み | 再生成しない | — |
また監査の観点では、生成した事実を追えるように generated_by / generated_at / prompt_version は実務上ほぼ必須です。
大量データは350行以内のバッチで生成する
Googleのヘルプでは、1回に生成されるのは、選択したAI関数のセルのうち最初の350個と案内されています。残りは生成が終わってから選択し直します。また、長期の生成上限に達すると、24時間は生成できなくなります。
AI関数は大量行を一気に回す用途には向きません。
だからこそ、最初から「分割バッチ」で設計しておくと詰みません。
実務の回し方としては、
- フィルタで「未生成」「生成済み」「要再生成」に分ける
- 350行ずつ生成(バッチ番号列があると管理が楽)
- 夜に生成 → 朝にレビュー、のように非同期に寄せる
この形に落とすと、生成上限やエラーの影響を局所化できます。
権限・機密・個人情報:AIに渡す前に“最小化”する
業務で一番事故が起きやすいのは、精度ではなく情報管理です。
AIに渡す情報は「必要最小限」に絞る設計が基本になります。
おすすめは次の対策です。
masked_input列を作り、メール・電話・住所・個人名などを置換してから渡す- AIに渡す範囲は「必要な列だけ」に限定する(丸ごと渡さない)
- チームで「送ってよい情報/だめな情報」を先に決める
導入判断に使える:運用チェックリスト
運用に乗せる前に、最低限ここだけ確認してください。
- AI出力は 型A(単一ラベル) か 型B(|区切り) になっている
- AI列は中間生成物で、Final列で確定する運用がある
valid_okで 壊れた出力を止められるprompt_versionを持ち、改善サイクルが回せる- 大量データは 分割バッチ前提になっている
- 機密・個人情報の扱いがルール化されている(masked_input等)
まとめ:AI関数は「AIを使う」より「AIが回る仕組み」を作るとうまくいく
AI関数の価値は、賢い文章を1回出すことではなく、同じ型で大量のテキストを、一定品質で処理し続けられるところにあります。
そして、そのために必要なのはプロンプトの工夫ではなく、列設計と運用設計です。
ここまでのテンプレを一度作っておくと、CS、採用、営業、経理など用途が増えても、同じ型で横展開できます。結果として「AIを導入したのに現場が疲れる」状態から抜け出しやすくなります。
よくある質問
AI関数をIF関数の中で使えますか?
使えません。Googleのヘルプでは、AI関数の入れ子は非対応で、IFで包む例も非対応として示されています。AI関数は単独の列に置き、判定は別の列で行います。
AI関数の結果を元に戻せますか?
元に戻す・やり直しはできず、再生成になります。確定した値はFinal列に値として固定し、AI列を再生成しても失われないようにします。
一度に何行まで生成できますか?
1回に生成されるのは、選択したAI関数のセルのうち最初の350個です。バッチ番号の列を作り、350行以内ずつ生成します。長期の上限に達すると24時間生成できなくなるため、締め切り直前の大量生成は避けます。
AI関数はどこから試すのが安全ですか?
要約、分類、次アクション抽出のような補助列から始めるのが安全です。契約条件や請求金額のような確定値を直接上書きする用途は避けるべきです。