AIエージェントを営業、サポート、社内自動化に入れると、最初の数ターンは自然に見えても、会話が長くなるほど話がかみ合わなくなることがあります。顧客がすでに答えたことを聞き直す、途中で意図を取り違える、関係ない知識を持ち込む、といった崩れ方です。
このとき原因を「モデルが弱い」「RAGが足りない」で片付けると、設計の論点を外します。実務で起きやすいのは、会話履歴、検索結果、ツール出力が同じ文脈枠を奪い合い、重要な前提が後ろへ押し出される コンテキストロット です。
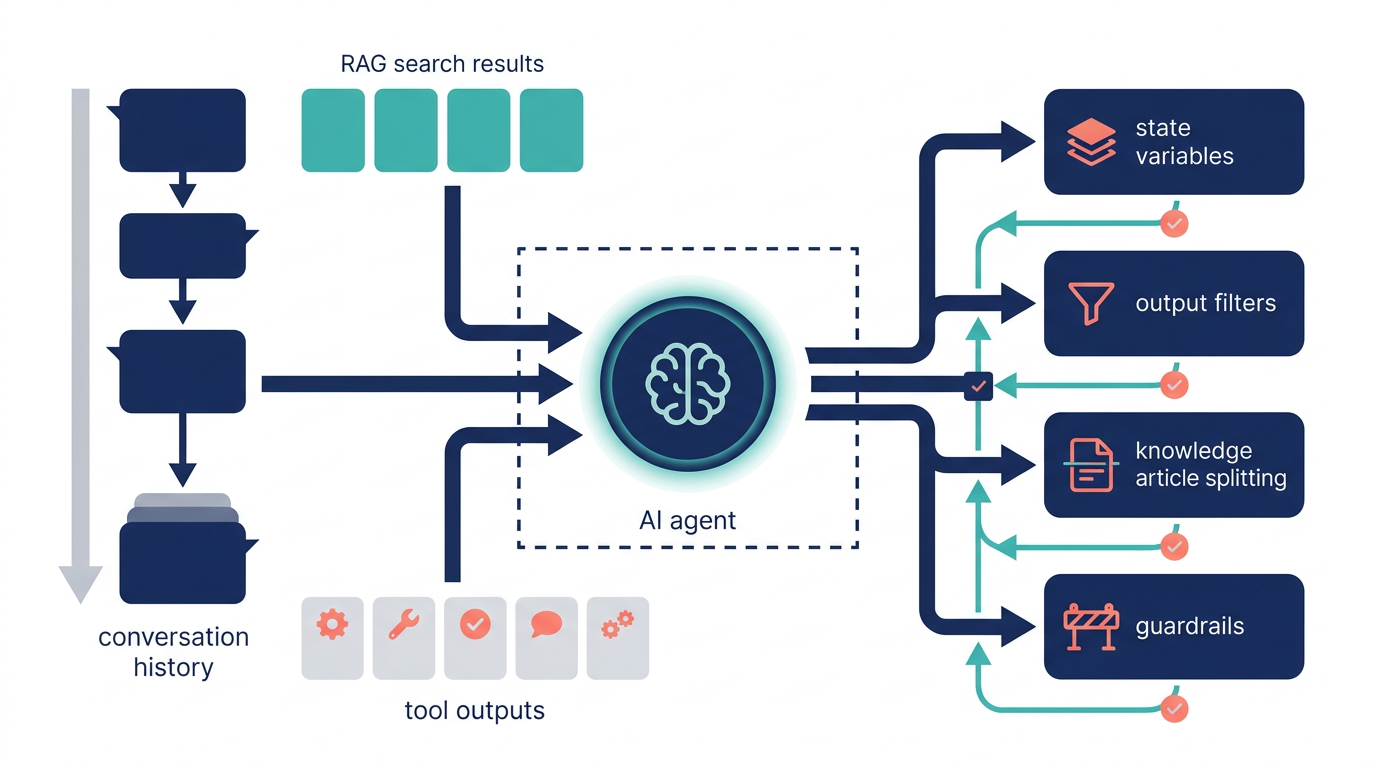
AIエージェントのコンテキストロットとは、会話履歴・検索した知識・ツールの返り値が同じ入力枠(コンテキスト)を取り合い、長い会話ほど最初の条件や途中の意図変更が押し出されて精度が落ちる現象です。短い会話では正しく答えるのに長い会話でだけ崩れるなら、RAG不足や権限不足よりこちらを先に疑います。対策は情報を足すことではなく、会話要約を決まった場面で更新し、ツールの返り値から次の判断に要る項目だけを残すことです。
要点
- コンテキストロットは、会話履歴・検索結果・ツール出力が同じ入力枠を取り合い、長い会話ほど最初の条件や意図変更が押し出されて精度が落ちる現象です。
- 短い会話では正しく長い会話でだけ崩れるならコンテキストロット、短くても誤るならRAGやモデル、特定操作だけ失敗するなら権限を疑います。
- 会話要約は条件変更・ツール実行・段階変更・引き継ぎの場面で更新し、ツール出力は次の判断に使う識別子と状態だけを残します。
コンテキストロットとは何か
コンテキストロットとは、AIエージェントが会話を続けるほど、保持しておくべき重要な前提が薄れたり抜け落ちたりして、推論の質が落ちる現象です。会話履歴が長くなるだけでなく、検索したナレッジ、APIやCRMから返ったデータ、途中で発生したツール出力も同じコンテキスト枠に入るため、必要な情報が競合します。
その結果、エージェントは「今の顧客意図」を見失い、古い前提やノイズの多い情報をもとにもっともらしい返答を作ります。営業なら商談目的を取り違える、サポートなら既出の回答を繰り返す、社内自動化なら途中で上書きされた条件を忘れる、といった形で現れます。
| 現象 | 内部で起きていること | 現場で見える症状 |
|---|---|---|
| 履歴の押し出し | 初期の顧客条件や意図変更が文脈枠から落ちる | すでに答えた質問を聞き直す |
| 検索ノイズの流入 | 多話題のナレッジ断片が大量に混ざる | 関係ないFAQや規約を持ち込む |
| 出力肥大化 | APIレスポンスやCRM全項目がそのまま入る | 途中から返答が鈍くなる、要点がぼやける |
| 古い状態の残留 | ユーザーが意図を変えても以前の状態が残る | 取り下げた依頼に基づいて動こうとする |
重要なのは、これは「AIがバカになった」のではなく、有限の文脈枠に対して情報を入れすぎた設計の問題 だということです。だから改善の主戦場はモデル変更ではなく、何を残し、何を捨てるかの設計になります。
RAG不足や権限不足と何が違うのか
コンテキストロットは、似た失敗要因と混同されやすい論点です。特に `RAG が弱い`, `権限が足りない`, `モデル精度が低い` は別の問題なので、切り分けを誤ると対策もずれます。
| 論点 | 何が足りない / 起きているか | 典型症状 | 主な対策 |
|---|---|---|---|
| コンテキストロット | 重要前提が文脈枠から押し出される | 長会話で精度低下、聞き直し、意図の逆戻り | 記事分割、出力整形、状態変数、ガードレール(止める条件) |
| RAG不足 | 必要な知識を拾えていない | 制度や規約を知らない、根拠が薄い | 検索対象の整備、検索単位(チャンク)の設計、記事追加 |
| 権限不足 | 必要データや操作権限にアクセスできない | 顧客情報を読めない、更新できない | 権限設計 の見直し |
| モデル精度不足 | 推論能力や指示追従が用途に合っていない | 短会話でも誤答が多い | モデル変更、prompt改善、評価設計 |
再現条件で見分ける
| こう再現するなら | 疑う原因 | 最初に確認すること |
|---|---|---|
| 短い会話でも同じ質問で誤答する | RAG不足・モデル性能 | 必要な記事が検索結果に入っているか、指示に従えているか |
| 特定の顧客・項目・操作だけ毎回失敗する | 権限不足 | エージェントの実行ユーザーが参照・更新できる範囲(権限設計) |
| 会話が長くなるか、ツールを何度も呼んだ後にだけ崩れる | コンテキストロット | 崩れる直前の入力に、古い条件や不要なツール出力がどれだけ入っているか |
| 部門によって同じ指標の答えが変わる | 意味定義の不一致 | 指標や項目の定義(セマンティックレイヤー) |
営業・サポート・社内自動化でどう現れるか
コンテキストロットは抽象概念に見えますが、現場ではかなり具体的に現れます。業務ごとに崩れ方が違うので、症状を業務文脈で見た方が判断しやすくなります。
営業AIエージェントの場合
顧客が「まずは情報収集」と言っていたのに、数ターン後にエージェントが商談化前提の提案へ飛ぶ、複数の決裁者情報を取り違える、すでに共有済みの資料を再送候補に入れる、といった形で表れます。特に CRM 出力をそのまま流し込むと、案件履歴のノイズで重要な直近意図が埋もれやすくなります。
サポートAIエージェントの場合
返金、停止、プラン変更のように途中で顧客意図が変わるケースで崩れやすくなります。最初は「解約したい」と言っていた顧客が、途中で「一時停止に変えたい」と修正したのに、後半でエージェントが解約フローに戻るのは典型例です。
社内自動化エージェントの場合
問い合わせ分類、台帳更新、承認依頼のようなフローで、途中で上書きされた条件を忘れます。たとえば「A部門案件だけSlack通知」「金額が50万円超なら人間承認」のような条件が、複数ツール出力の間で薄れて誤処理につながります。ここは SoA や AIエージェント ガバナンス とつないで考える必要があります。
防止策5つ
Salesforce の解説は Agentforce 向けですが、ナレッジ記事の分割など、他の製品でもそのまま使える論点を含みます。要点は「情報を足す」ではなく「残すべき情報だけを残す」ことです。
- 知識記事を単一論点に分割する
長く多話題のナレッジ記事は、検索時に不要な断片まで持ち込みます。返金、停止、権限変更、見積修正のように単一論点へ切ると、必要なチャンクだけを入れやすくなります。 - アクション出力を絞る
CRMや基幹システムの全レスポンスをそのまま渡さず、次の推論に必要な項目だけ残します。顧客名、案件ID、次回予定、最新ステージのように、判断に使う最小限へ落とす発想です。 - 状態変数を会話履歴の外に持つ
顧客意図、ケース要約、account ID、直前アクション結果など、後から上書きされうる重要状態は明示的に保持します。会話履歴だけに頼ると、長会話で簡単に落ちます。 - 止める条件(ガードレール)を先に置く
API応答の必須項目が欠けていたら、そのまま推論させず止めます。想定外の人への引き継ぎ(エスカレーション)や誤更新は、モデル誤答よりガードレール不足で起きることが多くなります。 - 長会話専用の評価指標を持つ
PoCでは平均正答率だけで満足せず、一定ターン数を超えた会話の解決率、聞き直し率、意図変更後の復元率、想定外の人への引き継ぎ(エスカレーション)率を分けて追います。
防止策のうち、設計で迷いやすいのは「会話要約をいつ作り直すか」と「ツールの返り値のどこを残すか」です。どちらも、会話の流れに任せず、更新する場面と残す項目を先に決めておくと崩れにくくなります。
会話要約を更新する場面
| 更新する場面 | 要約に書き足す・書き換える内容 | 更新しないと起きること |
|---|---|---|
| 利用者が条件や目的を変えたとき | 変更後の目的と、取り下げた依頼(「解約ではなく一時停止」など) | 取り下げた依頼のフローに戻る |
| ツールの実行が終わったとき | 実行した操作、結果、次に必要な確認 | 同じ照会や更新を繰り返す |
| 業務の段階が変わったとき | 前段で確定した事項だけ(ヒアリング完了→提案、など) | 確定済みの質問を聞き直す |
| 人へ引き継ぐとき | 顧客の意図、確定事項、未解決点、試した操作 | 担当者が最初から聞き直す |
ツール出力の保持基準
CRM や基幹システムの返り値は、全項目をそのまま会話に積まず、次の判断に使う項目だけを残します。
| 返り値の種類 | 扱い | 例 |
|---|---|---|
| 以後の判断に使う識別子・状態 | 状態として保持する | 顧客ID、案件ID、最新ステージ、次回予定日 |
| その場の判断にだけ使う詳細 | 要点を要約に書き、元データは捨てる | 活動履歴の全件 → 「直近の接触日と内容」 |
| エラー・欠損 | 原因と止めた理由を残し、推論を続けない | 必須項目が空 → 人へ確認を依頼 |
| 判断に使わない項目 | 入れない | 作成者ID、内部フラグ、未使用のカスタム項目 |
何を「状態」として保持するかは、顧客や案件の定義が揃っていることが前提です。定義の揃え方はセマンティックレイヤーで扱います。
PoCで確認すべき運用チェック項目
コンテキストロットは、公開デモや短い評価では見逃しやすいので、PoCの観測設計が重要です。最低でも次の4項目は別で見た方が、本番前に崩れを発見しやすくなります。
- 一定ターン数を超えた会話の解決率:短会話の平均に埋もれやすい長会話の劣化を見る。何ターンからを長い会話とみなすかは、自社の会話ログの分布で決める
- 聞き直し率:すでに答えた情報を再度要求していないかを見る
- 意図変更後の復元率:顧客が「やっぱり別案で」と変えた後に追従できるかを見る
- 想定外の人への引き継ぎ(エスカレーション)率:API不備や文脈崩れで不要に人間へ倒れていないかを見る
ここまで見ると、単純な「成功/失敗」ではなく、どの場面で崩れるかが見えてきます。長会話でだけ落ちるなら context rot、最初から必要情報を引けないなら RAG不足、特定操作だけ失敗するなら権限不足、という切り分けがしやすくなります。
よくある質問
AIエージェントのコンテキストロットとは何ですか?
会話履歴、検索結果、ツール出力が同じコンテキスト枠を奪い合い、長い会話ほど以前の重要な前提が落ちて精度が崩れる現象です。モデルの賢さより、情報の入れ方で起きやすくなります。
RAG不足とどう見分けますか?
同じ質問を短い会話で試し、そこでも誤るならRAG不足やモデル側、長い会話でだけ崩れるならコンテキストロットです。
最初に効く対策は何ですか?
知識記事の分割、アクション出力の絞り込み、状態変数の明示保持が最も効きやすい対策です。モデル変更はその後でも遅くありません。
会話要約はいつ作り直せばよいですか?
利用者が条件を変えたとき、ツールの実行が終わったとき、業務の段階が変わったとき、人へ引き継ぐときに更新します。会話のターン数だけで機械的に要約すると、取り下げた依頼が要約に残ることがあります。
PoCで何を測れば本番事故を防げますか?
平均値だけでなく、一定ターン数を超えた会話の解決率、聞き直し率、意図変更後の復元率、想定外の人への引き継ぎ(エスカレーション)率を別で追うと判断しやすくなります。